Wann lohnt sich selbst gehostete KI?
Eigenes Modell oder Modell-API? Mit einem Support-Test vergleicht ihr Antwortqualität, Wartezeit und Kosten für euren tatsächlichen Bedarf.
Ein Serviceteam möchte Fragen zu internen Handbüchern beantworten. Die Texte enthalten Preise und Produktdetails. Das Team hat zwei plausible Wege. Es kann ein Modell selbst betreiben oder die Anfragen an eine Modell-API senden, sofern die Daten dafür freigegeben sind. Die Entscheidung fällt beim Betrieb unter Last und bei den Antworten, die der Support übernehmen kann.
Unser Beitrag zu Open WebUI zeigt, wie eine Oberfläche mehrere Modelle anbinden kann. Für die Betriebsentscheidung lohnt es sich, die Oberfläche vom Modellserver zu unterscheiden. Ein Chatfenster auf dem eigenen Server kann Anfragen weiterhin an einen externen Anbieter weiterleiten. Zeichnet den gesamten Datenweg auf, inklusive Dokumentensuche, Modellaufruf, Protokollen und Werkzeugen, die der Assistent nutzt.
Welche Modelle in den Vergleich gehören
Modelle mit veröffentlichten Gewichten lassen sich in einer eigenen Umgebung betreiben. Google dokumentiert Gemma 4 in verschiedenen Größen, darunter kleine Varianten. Mistral bietet mit Large 4 auch ein sehr großes Modell zur eigenen Bereitstellung an. Das Spektrum ist breit. Für den Vergleich zählt, welche Variante eure Anforderungen mit der verfügbaren Hardware und der passenden Lizenz erfüllt. Google zu Gemma · Mistral zu Large 4 und dessen Lizenz
„Selbst gehostet“ kann ein Server im eigenen Rechenzentrum oder ein selbst verwalteter Dienst auf gemieteter Infrastruktur sein. In beiden Fällen braucht ihr Verantwortliche für Updates, Auslastung und Störungen. Bei einer API prüft ihr insbesondere Verarbeitungsregion, Datenflüsse und Einstellungen für Aufbewahrung und Protokolle. Die Modelllizenz und der Hostingvertrag beantworten unterschiedliche Fragen.
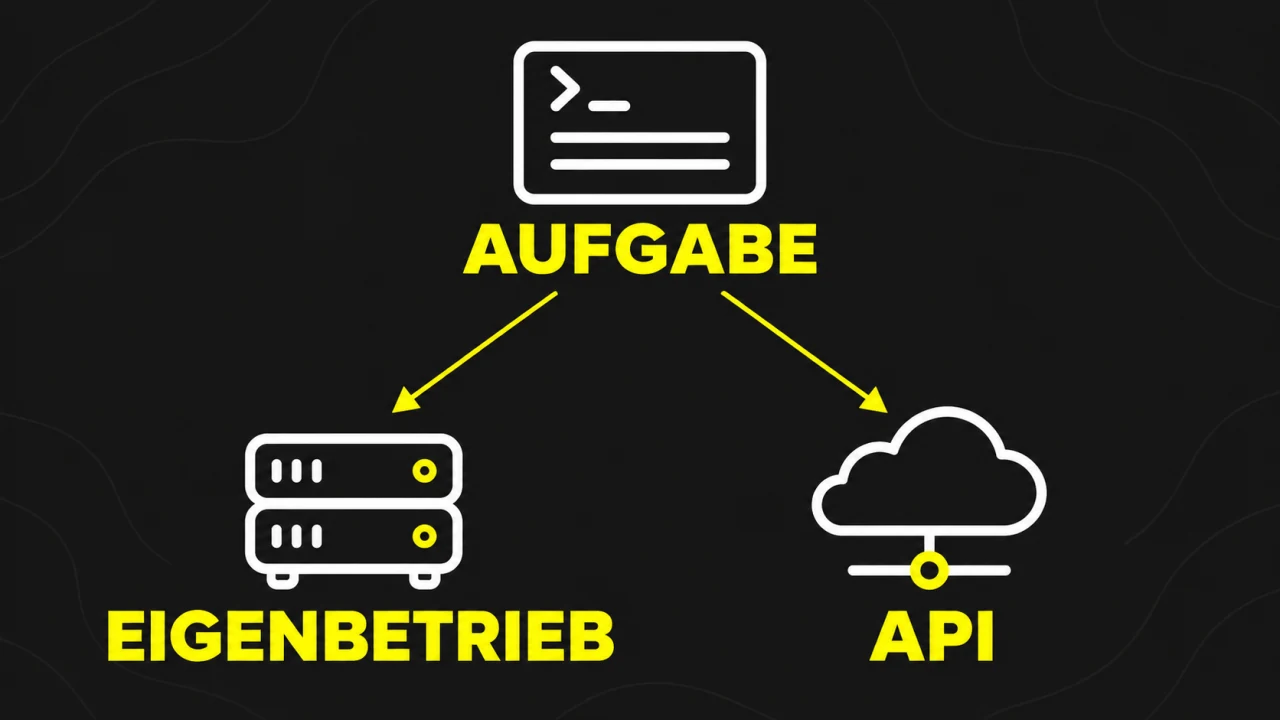
So vergleicht ihr die beiden Wege
Zieht eine Stichprobe aus dem Support und entfernt vertrauliche Angaben für den Vergleich, falls sie bei einem Anbieter nicht verarbeitet werden dürfen. Nehmt auch Fragen mit fehlenden, widersprüchlichen oder veralteten Quellen auf. Bewertet Antworten möglichst ohne Kenntnis des verwendeten Modells. Messt, ob die Antwort fachlich richtig ist, einen passenden Beleg enthält und bei fehlender Grundlage an das Team verweist.
Lasst beide Varianten möglichst mit demselben Dokumentbestand und denselben Suchergebnissen arbeiten, wenn ihr die Modelle vergleichen wollt. Ein separater Durchlauf mit den jeweiligen produktiven Einstellungen zeigt, wie sich die ganzen Systeme im Betrieb schlagen. Testet mehrere gleichzeitige Anfragen und erfasst, wie lange die langsamsten Fälle warten. Gerade beim Eigenbetrieb können sich längere Dokumente und Stoßzeiten bemerkbar machen.
Was eine brauchbare Antwort kostet
Teilt die gesamten Monatskosten durch die Zahl der Antworten, die ohne fachliche Korrektur übernommen werden können. Für den Eigenbetrieb gehören Hardware oder Servermiete, Überwachung und Betreuung in die Rechnung. Bei der API zählen Modellaufrufe, Dokumentensuche, Wiederholungen und Betreuung ebenfalls dazu.
In einer fiktiven Rechnung kostet die eigene Installation im Monat 800 Euro und liefert 2.000 direkt nutzbare Antworten. Das sind 40 Cent pro Antwort. Die API-Variante kostet 950 Euro und liefert 2.500 direkt nutzbare Antworten. Sie liegt bei 38 Cent. Rechnet die verbleibenden Fälle separat nach, denn auch die Zeit für deren Bearbeitung beeinflusst die Wahl.
Ein stabiler Standardfall mit regelmäßigem Volumen ist ein guter Kandidat für einen Test im Eigenbetrieb. Für seltene, schwierige Fälle kann eine API eine weitere Option sein. Legt bei einer solchen Kombination fest, welche Daten die eigene Umgebung verlassen dürfen und was die Anwendung bei einem Ausfall tut.
Quellen
- Google, Gemma-Modellveröffentlichungen.
- Mistral, Mistral Large 4 mit veröffentlichten Gewichten.
- Lumentis AI, Open WebUI im Unternehmenseinsatz.